Für viele Softwareentwickler ist dieser Gedanke schwer auszuhalten: Man muss nicht zwingend jede Zeile KI-generierten Code lesen.
Das klingt verantwortungslos. Deshalb die präzise Form: Du musst nicht jede Zeile lesen, wenn dein Verifikationssystem stark genug für das Risiko der Änderung ist.
Das ist kein Aufruf, beliebige Agenten-Ausgaben blind auszuliefern. „Ich habe jede Zeile persönlich gelesen“ ist nur nicht der einzige Qualitätsmaßstab. In vielen Fällen ist es nicht einmal der beste.
Wir vertrauen längst Systemen statt einzelnen Zeilen
Ein nicht technischer Geschäftsführer kann die Veröffentlichung eines Produkts freigeben, ohne dessen Code gelesen zu haben. Ein Engineering Manager trägt Verantwortung für ein Release, ohne jedes Implementierungsdetail selbst zu prüfen. Auch in ernsthaften Branchen wird Software ausgeliefert, ohne dass jede Führungskraft jeden Diff kontrolliert.
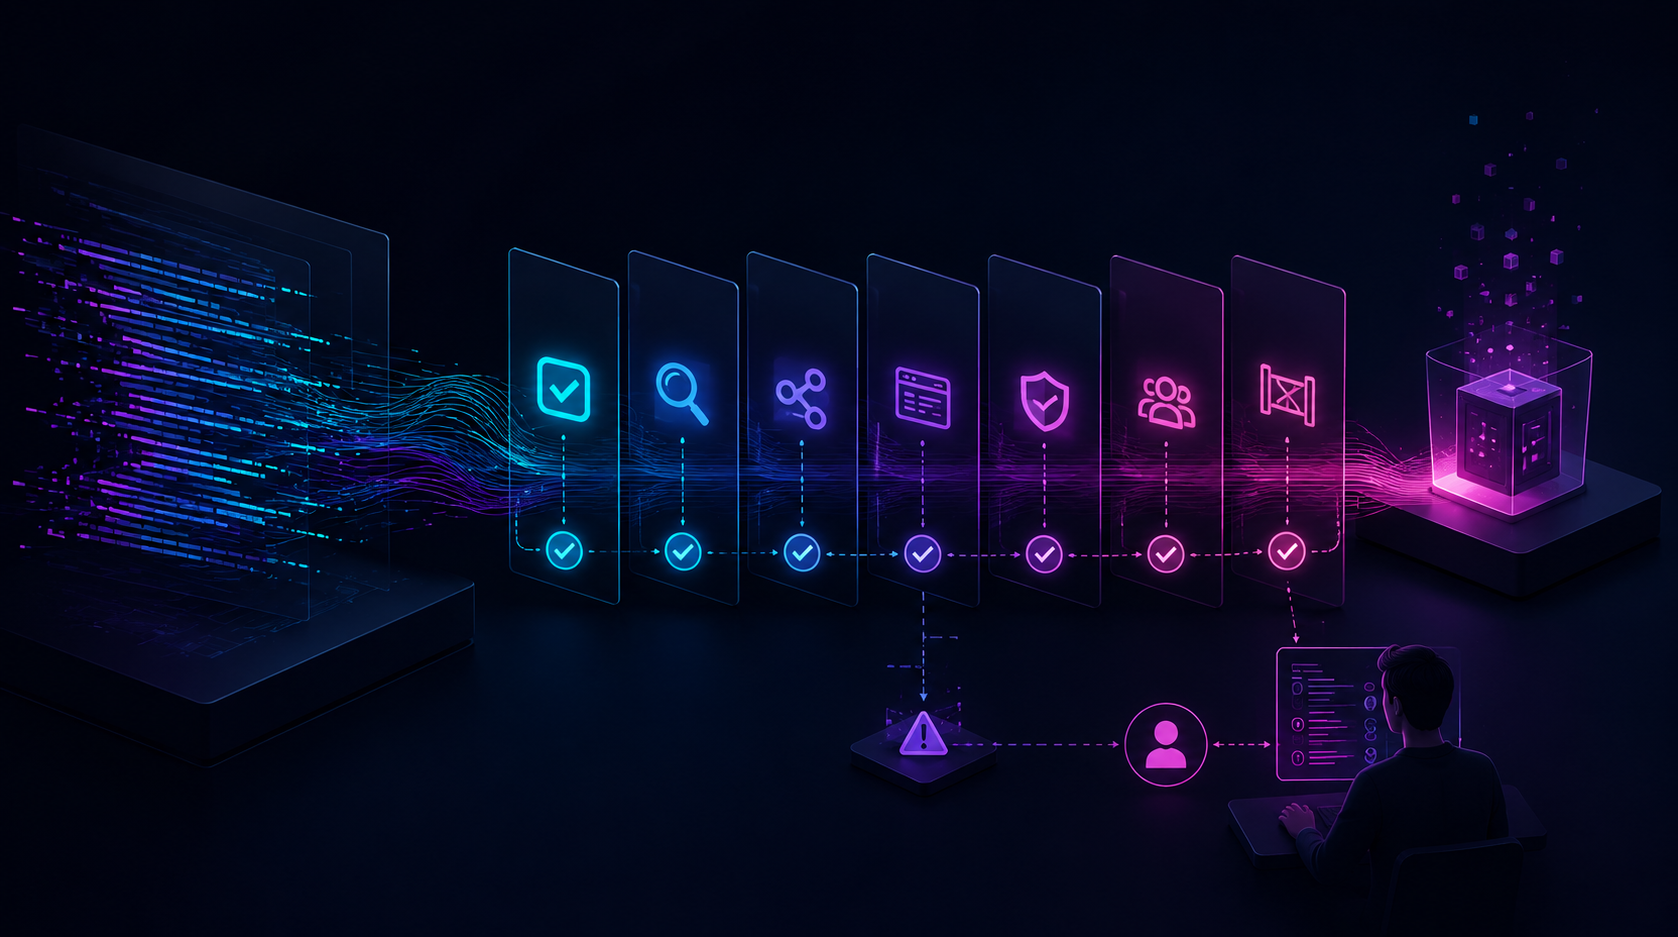
Das funktioniert, weil Vertrauen durch Systeme entsteht: Leitplanken, Tests, Reviews, statische Analyse, Qualitätsmanagement, Release Gates, Monitoring, Rollback-Mechanismen, Audit Trails und getrennte Verantwortlichkeiten.
Code Review kann Teil dieses Systems sein, ist aber nicht das ganze System. Menschliche Reviews sind nicht magisch. Jeder hat schon einen Pull Request freigegeben, der später etwas beschädigte. Kommentare zu Benennungen können gleichzeitig den eigentlichen Bug übersehen. Ein einziger Test hätte manchen Edge Case zuverlässiger gefunden.
Die relevante Frage ist deshalb nicht, ob ein Mensch eine Zeile gelesen hat. Sie lautet: Was gibt uns begründetes Vertrauen, dass diese Änderung sicher genug für die Auslieferung ist?
Der alte Qualitätsmaßstab wird zum Engpass
Lange galt: Ich muss jede Zeile verstehen, bevor ich dem Code vertrauen kann. Das war nachvollziehbar, als Menschen Code schrieben, Menschen ihn prüften und Menschen ihn auslieferten.
Mit KI verändert sich die Ökonomie. Ein Agent kann mehrere Implementierungsversuche erzeugen, während ein Mensch einen davon gründlich liest. Zeilenweises Review wird zum Flaschenhals.
Muss weiterhin jeder Fehler durch menschliche Aufmerksamkeit entdeckt werden, ist wenig automatisiert. Nur das Tippen wurde an die KI ausgelagert, die gesamte Verifikationslast bleibt bestehen. Der sinnvollere Weg verschiebt so viel Prüfung wie möglich in das System.
Die bessere Frage
Statt „Sieht diese Zeile für mich richtig aus?“ sollte man fragen: „Welche grünen Checks brauche ich, um dieser Änderung zu vertrauen?“
Für eine UI-Änderung kann das ein Browser-Test des zentralen Ablaufs sein. Eine Datenbankmigration braucht Sicherheitsprüfungen und eine Rollback-Strategie. Eine API-Änderung braucht Contract Tests. Sicherheitskritischer Code braucht menschliches Review, statische Analyse und gezielte Tests. Übersetzungen brauchen Locale-Parität. Bei Refactorings verhindert ein Diff-Guard, dass verbotene Abhängigkeiten zurückkehren.
Nicht jede Änderung braucht denselben Prozess. Der Prozess muss aber explizit sein und zum Risiko passen. „Ich habe kurz drübergesehen“ ist kein belastbares Kontrollsystem.
So arbeiten wir in der Praxis
Bei Nodl und Zedl ist „jede Zeile gelesen“ nicht mehr unser allgemeiner Qualitätsmaßstab. Der Agent muss Änderungen erzeugen, die das Übergabekriterium bestehen.
Oft ist dieses Kriterium ein Befehl wie:
make check
Dahinter liegen Migrationsprüfungen, statische Analyse, der Abgleich zwischen Modell und Datenbank-Constraints sowie die vollständige Testsuite. Kritische Produktabläufe werden zusätzlich durch Headless-Browser-Tests geprüft. Ist das Gate rot, arbeitet der Agent weiter. Ist es grün, ist die Änderung normalerweise übergabefähig.
Entscheidend ist nicht der Name des Befehls, sondern sein Inhalt. Unsere Regel lautet: Invarianten werden durch Checks erzwungen, nicht durch Konventionen.
Verschlüsselte Datei-Uploads, TLS zu AI-Providern, Klassennamen wiederkehrender Jobs, Locale-Parität, Constraints und zentrale Browser-Abläufe dürfen nicht nur in Erinnerung oder Dokumentation existieren. Was niemals still brechen darf, braucht einen ausführbaren Check.
Fehlermeldungen sind eine Schnittstelle für Agenten
Menschen tolerieren schlechte Testmeldungen, weil sie den Kontext untersuchen können. Für einen Agenten im Loop ist die Fehlermeldung Teil der Schnittstelle.
„Test fehlgeschlagen“ hilft kaum. Gute Meldungen erklären den nächsten Schritt:
In der deutschen Locale-Datei fehlt der Key dashboard.uploads.title. Ergänze ihn, bevor du die Aufgabe abschließt.
Die Datenbankspalte erlaubt Nullwerte, das Anwendungsmodell verlangt aber einen Wert. Gleiche Constraint und Validierung an.
Dieser Diff führt eine neue postcss-Referenz ein. Entferne sie während dieser Migration.
Der Agent sieht den Fehler, korrigiert die Ursache und führt den Check erneut aus. Ein Mensch muss keine Stack Traces kopieren. Genau dieser Loop macht AI Coding nützlich. Nicht weil das Modell fehlerfrei wäre, sondern weil Fehler billig werden.
Menschliches Review bleibt eine Kontrolle
Natürlich sollte nicht jeder KI-generierte Code ohne Review in Produktion gehen. Bei Security, Zahlungslogik, Authentifizierung, Autorisierung, Datenlöschung, komplexen Migrationen sowie rechtlichen, medizinischen oder finanziellen Risiken will ich weiterhin menschliche Augen. Dasselbe gilt, wenn das Verifikationssystem noch nicht ausgereift ist.
Der Punkt ist nicht, Urteil vollständig durch Tests zu ersetzen. Menschliches Urteil sollte nur nicht die einzige Prüfschicht für jede Änderung sein. Lässt sich eine Fehlerklasse als Test, Lint-Regel, statischer Check, Diff-Guard oder Browser-Assertion formulieren, sollte genau das geschehen.
Jeder Fehler kann das System verbessern
Wenn ein Mensch einen Agentenfehler findet, folgt eine weitere Frage: Kann diese Fehlerklasse unmöglich oder zumindest billig erkennbar werden? Falls ja, entsteht daraus ein neuer Check.
Dem Agenten nur zu sagen, er solle denselben Fehler nicht wiederholen, reicht nicht. Prompts sind schwach, Checks sind stärker. Ziel ist nicht, dieselbe Art Fehler dauerhaft manuell zu korrigieren.
Mit der Zeit sammelt das System Narbengewebe. Jeder Bug, jede unsichere Migration, jeder fehlende Locale-Key und jeder gebrochene Browser-Ablauf kann eine neue Leitplanke erzeugen. AI Coding wird dadurch weniger riskant, weil der Prozess schwerer zu täuschen ist, nicht weil der Agent plötzlich perfekt wird.
Worauf ich tatsächlich vertraue
Beim Ausliefern KI-generierten Codes vertraue ich nicht auf die Intelligenz eines Modells. Ich vertraue auf den kontrollierten Prozess: Tests, statische Checks, Migrationssicherheit, Browser-Tests, Diff-Guards und dass der Agent dasselbe Gate ausführen musste, das ich selbst verwenden würde.
Reicht dieses Vertrauen für eine Änderung nicht aus, lese ich den Code. Human Review bleibt ein Werkzeug im System, aber nicht das gesamte System.
Der eigentliche Wandel
Der Wandel lautet nicht, weniger auf Codequalität zu achten. Im Gegenteil: Persönliche Inspektion darf nicht der wichtigste Qualitätsmechanismus bleiben. Ein gutes System schafft begründetes Vertrauen, fängt bekannte Fehler ab, gibt schnelles Feedback und passt seine Kontrollen an das Risiko an.
Dann wird die Frage nüchterner. Ist das Verifikationssystem für diese Änderung stark genug? Manchmal lautet die Antwort nein. Dann braucht es Code Review, zusätzliche Tests und ein stärkeres Gate. Oft lautet sie aber ja. In diesen Fällen erzeugt das Lesen jeder Zeile vor allem das Gefühl von Beteiligung. Dieses Gefühl ist nicht dasselbe wie Sicherheit.
Das Zielbild
AI Coding führt weder zu blindem Vertrauen noch zum Verschwinden von Menschen aus der Softwareentwicklung. Es entsteht ein anderes Vertrauensmodell: Der Mensch entwirft das System aus Constraints, der Agent arbeitet darin, Checks liefern Rückmeldung, der Agent iteriert und der Mensch greift dort ein, wo Risiko, Geschmack oder fehlende Verifikation es verlangen.
Ob KI programmieren kann, hängt in der Praxis von Aufgabe, Code und Verifikationssystem ab. Man muss nicht jede Zeile lesen. Man muss wissen, was den Fehler gefunden hätte.
Für wen das relevant ist
- Entwickler, die Code ohne vollständiges Zeilenreview ausliefern und dafür einen belastbaren Maßstab brauchen
- Engineering Leads, die Review-Prozesse für agentenreiche Entwicklung gestalten
- Kleine Produktteams, die nicht jeden Diff persönlich prüfen können
- Verantwortliche in regulierten oder riskanten Bereichen, die menschliche Kontrollen gezielt einsetzen wollen
Häufige Fragen
Ist es sicher, KI-generierten Code auszuliefern, ohne jede Zeile zu lesen? Es kann sicher sein, wenn das Verifikationssystem zum Risiko passt. Tests, statische Analyse, Diff-Guards und Browser-Tests schaffen begründetes Vertrauen. Zeilenreview ist eine Kontrolle unter mehreren.
Wann sollte ein Mensch weiterhin reviewen? Bei Security, Zahlungen, Authentifizierung, Autorisierung, Datenlöschung, komplexen Migrationen, hohen rechtlichen oder finanziellen Risiken und überall dort, wo die automatisierte Verifikation noch schwach ist.
Was ist ein Handoff Gate? Ein einzelner Befehl wie make check, der alle relevanten Prüfungen ausführt. Der Agent arbeitet weiter, bis dieses Gate grün ist.
Warum müssen Fehlermeldungen für Agenten geschrieben sein? Weil die Meldung ihre Schnittstelle zum Verifikationssystem ist. Eine konkrete Ursache und Korrekturanweisung ermöglicht selbstständige Iteration.
Was bedeutet „Invarianten durch Checks statt Konventionen“? Eine Bedingung, die niemals still brechen darf, gehört in eine ausführbare Prüfung und nicht nur in einen Prompt, eine Dokumentation oder das Gedächtnis eines Menschen.
Wie hängt dieser Artikel mit den anderen zusammen? Er folgt aus zwei Beobachtungen: KI kann programmieren, wenn Verifikation billig ist, und KI scheitert oft an implizitem menschlichem Geschmack. Weniger Zeilenreview ist die praktische Konsequenz eines stärkeren Systems.